這是一篇為您量身打造的 EDA 最終章教學。這篇文章將完美補齊您的「機器學習煉金術」系列,並且直接把您剛才遇到的「極端值地雷」寫入實戰案例中!
機器學習煉金術三部曲:解密 Histogram Grid —— 揪出摧毀模型的「極端值地雷」
如果您已經跟著前兩篇文章的腳步,使用「目標相關性長條圖 (Target Bars)」挑出了會賺錢的黃金特徵,並且用「特徵熱力圖 (Heatmap)」開除了互相抄襲的冗餘特徵,您可能以為您的特徵矩陣已經完美無瑕,準備好丟給機器學習模型去印鈔票了。
請等一下!在按下「Train(訓練)」按鈕之前,您還有最後一道、也是最攸關生死的安全檢查尚未完成。
在數據科學界有一句名言:「Garbage In, Garbage Out(垃圾進,垃圾出)」。即便一個特徵在線性相關性上表現極佳,只要它內部藏著幾個「除以零」造成的毀滅性極端值,就能瞬間把 XGBoost 或 Random Forest 的決策樹徹底毒啞。
而用來進行這項最終健康檢查的 X 光機,就是我們今天要介紹的 特徵分佈直方圖 (Histogram Grid)。
什麼是 Histogram Grid (直方圖網格)?
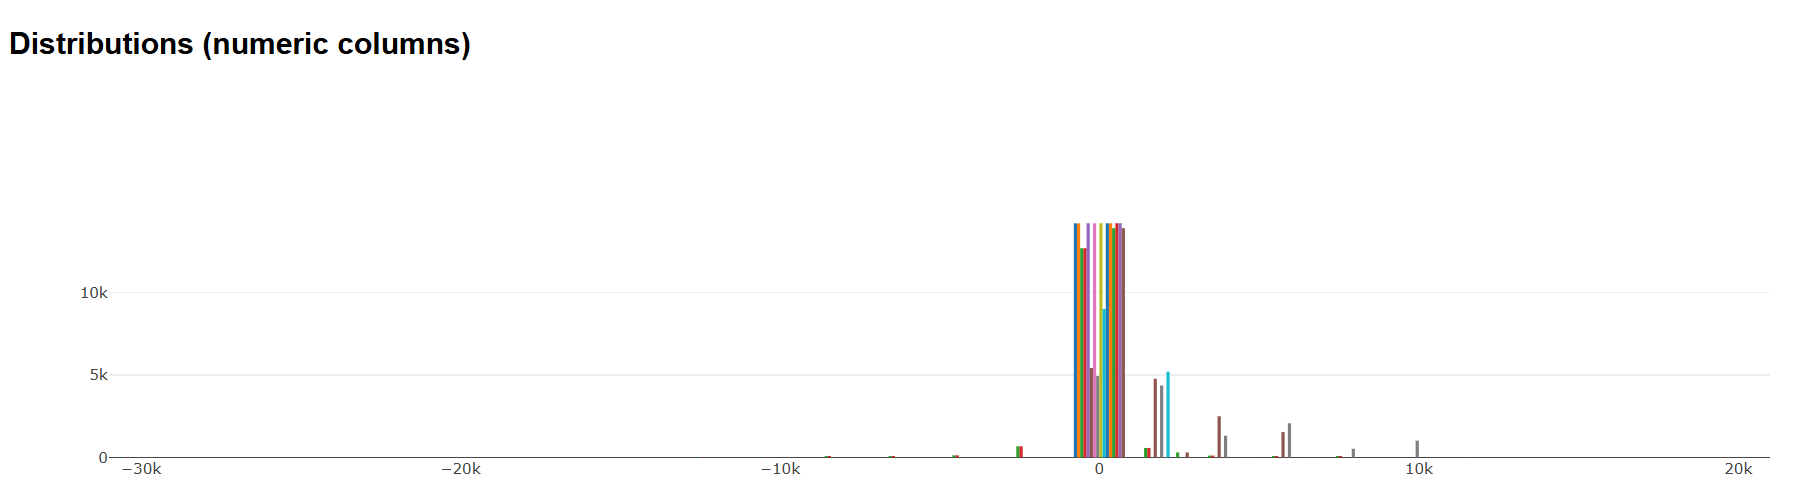
showHistogramGrid 會為您的每一個特徵繪製一張獨立的「直方圖 (Histogram)」。
與看價格走勢的 K 線圖不同,直方圖不看時間,它看的是「數值的聚集程度」。
-
X 軸 (橫軸):代表該特徵的數值大小(例如從 -5.0 到 +5.0)。
-
Y 軸 (縱軸):代表該數值在您的歷史回測中「出現的次數 (Frequency/Count)」。
當您把幾十個特徵的直方圖排成一整面「網格 (Grid)」時,您就能像上帝視角一樣,一眼看穿每一個特徵的「體質」是健康還是病態。
臨床診斷:如何看懂直方圖的三種典型狀態?
在量化交易的 EDA 中,我們打開直方圖網格,主要是在尋找以下三種分佈形態:
1. 完美的模範生:常態分佈 (Normal/Bell-Curve Distribution)
-
長相:中間有一座高高的山峰,兩側平滑且對稱地遞減,長得像一個倒蓋的鐘。
-
解讀:這是機器學習模型最喜歡的食物。例如您的「平均擺盪天數的偏差值」,大多數時候都在平均值附近徘徊,偶爾才有極端長或極端短的波段。這種數據餵給模型,學習效果最好、最穩定。
2. 需要校正的偏科生:長尾分佈 (Skewed/Fat-Tail Distribution)
-
長相:數據擠在左邊形成一座高山,但右邊拖著一條長長的、幾乎貼地的尾巴(右偏態);反之亦然。
-
解讀:金融市場中的「成交量」或「波動率絕對值」通常長這樣(大多數時候交易冷清,極少數時候爆量)。這不算錯誤,但神經網路(Neural Networks)對這種數據吸收不良。
-
處方籤:通常會將這類特徵進行 Log Transform (取對數),把長尾巴捲回來,讓它變得更像常態分佈。(註:不過隨機森林對長尾分佈的容忍度很高,通常可以不處理)。
3. 💣 致命的恐怖份子:極端異常值 (Extreme Outliers)
-
長相:您會看到整張圖的 99.9% 數據變成一根極度細長的棍子擠在
0的位置。但 X 軸的座標卻被拉得無限長(例如延伸到了10k,20k,30k),而在遙遠的30k盡頭,只有幾個肉眼幾乎看不見的像素點。 -
解讀:這代表您的程式碼發生了嚴重的數學錯誤(通常是除以接近零的數)! ---
實戰案例解剖:為什麼會產生 30,000 的極端值?
讓我們拿量化程式交易中最常發生的錯誤來做實例剖析。
在您的 T3 模型中,您設計了一個極具洞察力的特徵:deltaYYR (價格推升力道)。
它的公式是:deltaYYR = 價格變化量 (Delta) / 陰陽率標準差 (sdWidth)。
在 99% 的情況下,這個公式運作完美,算出來的值大約在 -3.0 到 +3.0 之間。
但是,市場總有死水微瀾的時候。
假設在某個深夜的冷門時段,市場幾乎完全不動,您的 sdWidth 收斂到了極限,變成了 0.00001。
此時,只要價格輕輕跳動了 0.5 點。
您的公式:0.5 / 0.00001 = 50,000!
這個 50,000 的天文數字就這樣被悄悄寫入了您的 MLTrainDataForPnL 表格中。
為什麼這會摧毀隨機森林?
隨機森林在訓練時,會不斷尋找「最佳切分點(Split Point)」。當它的資料庫裡同時存在 -1.2, 0.8, 2.1 和一個 50,000 時,演算法會被這個 50,000 嚴重干擾。它可能會浪費寶貴的決策樹深度,去試圖把 50,000 獨立切分出來,導致模型對正常的 0.8 和 2.1 失去辨識能力。
終極解藥:資料清洗與保護機制 (Data Sanitization)
當 Histogram Grid 幫您揪出了這些極端地雷後,我們必須回到 Java 程式碼中,實作量化交易必備的「防護罩」:
防護罩一:底線攔截 (Zero-Division Protection)
在任何相除的公式前,強制檢查分母:
Java
// 在 MLTrainDataForPnL 或 TPRDEvaluator 中
if (sdWidth < 0.0001) {
    return 0.0; // 如果通道幾乎消失,視為無動能,直接回傳 0
}
double deltaYYR = delta / sdWidth;
防護罩二:極值截斷法 (Winsorizing / Clipping)
即使分母不是零,我們也要為特徵設定一個「物理極限」。我們知道正常的波動在 5 個標準差以內就已經是極限了。
Java
// 將特徵強制鎖死在 -10.0 到 10.0 之間
double safeDeltaYYR = Math.max(-10.0, Math.min(10.0, delta / sdWidth));
當您加上了這兩層防護罩,再次重新跑出 showHistogramGrid 時,您會發現那根遙遠的 30k 消失了,原本擠在一起的棍子,瞬間展開成了漂亮、健康的波動率分佈圖!
總結:EDA 的神聖三位一體
恭喜您!走到這一步,您已經完整掌握了機構級量化團隊的特徵工程 (Feature Engineering) 核心流程:
-
🎯 Target Correlation Bars:尋找 Alpha (預測獲利的能力)。
-
🔥 Correlation Heatmap:消除 Beta / 冗餘 (確保特徵正交性)。
-
📊 Histogram Grid:確保 Data Quality (掃除極端值地雷)。
經過這「神聖三位一體」洗禮的資料集,已經不再是生肉,而是最頂級的 A5 和牛。現在,您可以充滿自信地將這份乾淨、高訊號、無雜訊的矩陣,餵給您的機器學習模型,準備迎接那條平滑向上的淨值曲線了!