機器學習煉金術:解密 Target Correlation Bars —— 如何從海量數據中揪出真正有用的特徵?
在機器學習的特徵工程(Feature Engineering)中,我們常面臨一個經典的挑戰:「我辛苦清洗、轉換出的這 100 個特徵,到底哪些對預測目標真的有貢獻?」
新手常犯的錯誤是將所有特徵一股腦地塞進 Random Forest 或 XGBoost。這不僅會導致「維度災難(Curse of Dimensionality)」、拖慢訓練速度,更會引入大量雜訊(Noise),讓模型在訓練集表現完美,測試時卻慘不忍睹(Overfitting)。
要解決這個問題,在進入模型訓練前,我們必須進行深度 EDA(探索性資料分析)。而最直觀、最能一針見血判斷特徵價值的工具,就是 「目標相關性長條圖 (Target Correlation Bars)」。
什麼是 Target Correlation Bars?
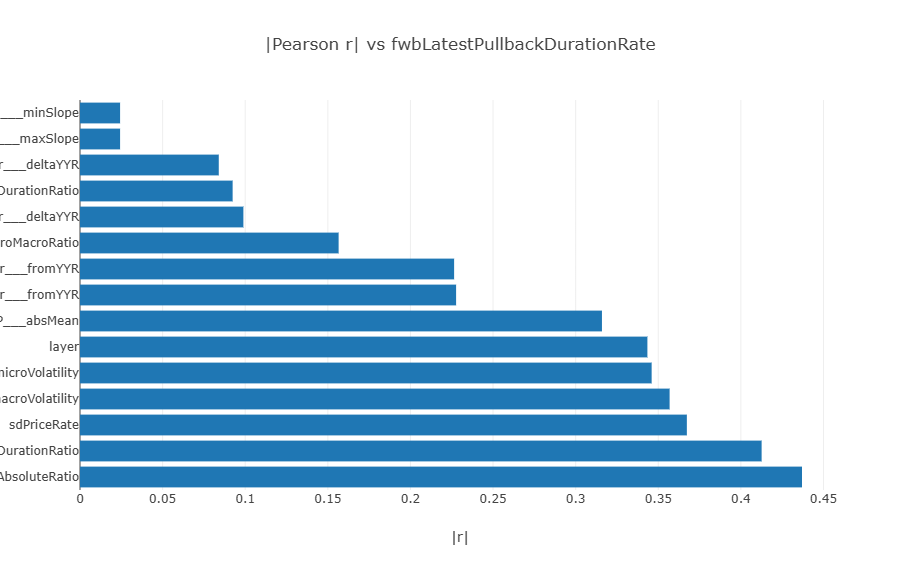
這是一張水平長條圖(Horizontal Bar Chart),它的視覺結構非常簡單明瞭:
-
Y 軸 (縱軸):列出數據集中所有的候選特徵(Features)。
-
X 軸 (橫軸):顯示特徵與「目標變數(Target)」之間的關聯強度,數值介於 $0$ 到 $1$。
這張圖表的唯一任務,就是對所有特徵進行一場「選秀」,幫助我們淘汰那些與預測目標毫無關係的冗餘特徵。
核心解密:長條圖背後的數學引擎
這張圖表的核心,通常是統計學中的 皮爾森相關係數 (Pearson Correlation Coefficient, $r$)。
1. 什麼是皮爾森相關係數 ($r$)?
它用來衡量兩個連續變數之間的線性相關程度。計算公式如下:
$$r = \frac{\sum (X_i - \bar{X})(Y_i - \bar{Y})}{\sqrt{\sum (X_i - \bar{X})^2 \sum (Y_i - \bar{Y})^2}}$$
-
$r \approx 1.0$ (強正相關):特徵增加,目標變數也隨之增加。
-
$r \approx -1.0$ (強負相關):特徵增加,目標變數反而減少。
-
$r \approx 0$ (無相關):特徵的變化跟目標變數完全隨機,屬於純雜訊。
2. 為什麼 X 軸要取「絕對值」 $|r|$?
在特徵篩選中,「強烈的負相關」與「強烈的正相關」同樣有價值。
舉例來說,若我們要預測房價:
-
特徵 A「坪數」與房價是 正相關 ($r=0.6$)。
-
特徵 B「屋齡」與房價是 負相關 ($r=-0.6$)。
對於機器學習模型(尤其是決策樹類模型)來說,這兩個特徵的預測能力是一樣強的。為了視覺上的直觀對比,我們會取絕對值 $|r|$ 並由大到小排序。這樣你只需看「誰的柱子最長」,就能立刻抓出最強的預測因子。
實戰應用:如何解讀這張圖?
當你畫出這張圖後,請執行以下三個標準動作:
動作一:鎖定「黃金特徵 (Golden Features)」
目光看往圖表最上方。在一般的非平穩數據中,若 $|r| > 0.1$ 甚至 $> 0.3$,通常代表該特徵具有顯著的解釋力。這些特徵將是你模型準確度的基石。
動作二:剔除「無效雜訊 (Garbage Features)」
目光移到圖表下方 $|r| < 0.01$ 的區域。這些特徵在統計上對目標變數幾乎沒有貢獻。大膽地在訓練前將它們 Drop 掉,這能有效減少模型負擔,讓模型更專注於真正的規律,提升泛化能力(Generalization)。
動作三:警覺「資料洩漏 (Data Leakage)」
這是一個避坑指南! 如果你發現某個特徵的 $|r|$ 高達 0.9 以上(長條頂天),別高興得太早,這通常是「資料洩漏」的警訊。
這代表該特徵可能在無意中包含了目標變數的資訊(例如:在預測「是否違約」的模型中,不小心放入了「違約後的催收紀錄」)。這種模型在線下測試會達到 100% 準確率,但在實際預測未知數據時會徹底失效。
總結
Target Correlation Bars 是資料科學家的「第一道篩選器」。它用客觀的數學指標,戳破了我們對某些特徵的過度幻想,也指出了數據中真正隱藏的關鍵。
當你透過這張圖篩選出一批「高關聯特徵」後,下一步建議配合 特徵熱力圖 (Correlation Heatmap),檢查特徵彼此間是否有「共線性」問題,進一步精煉你的特徵矩陣!