這是一份為你整合了 DuckDB 高效查詢、內建驅動連線,以及免寫 SQL 直接透過 UI 預覽與匯出資料的完整 DBeaver Parquet 教學文件。在處理龐大的結構化資料(例如量化交易的歷史回測數據或 AI 模型的訓練樣本)時,這套流程能大幅提升資料探索的效率。
DBeaver 讀取與分析 Parquet 檔案完整教學
在 DBeaver 中處理 Parquet 檔案,主要有兩種連線方式:「透過 DuckDB 引擎」與「使用內建 Parquet 驅動」。連線建立後,皆可透過 SQL 查詢或純 UI 介面進行資料探索與格式轉換。
方案比較總覽
| 特性 | DuckDB 連線 (最推薦) | DBeaver 內建 Parquet 驅動 |
|---|---|---|
| 適用情境 | 需執行複雜 SQL (JOIN, GROUP BY)、處理極大型資料 |
快速檢視單一檔案或資料夾、不需寫程式 |
| 查詢效能 | 極快 (專為分析打造的列式記憶體引擎) | 較慢 (複雜查詢時,背景會轉存入內部 SQLite) |
| 操作方式 | 需手動輸入路徑建立虛擬連線 | 點擊瀏覽檔案目錄即可建立 |
方法一:使用 DuckDB 建立高效分析環境 (推薦)
DuckDB 是一個輕量級的分析型資料庫,能將本機的 Parquet 檔案直接當作資料表查詢,完全不需事先將資料倒進資料庫中。
Step 1: 建立 DuckDB 記憶體連線
-
打開 DBeaver,點擊左上角 「新增資料庫連線」 (New Database Connection)。
-
搜尋並選取
DuckDB,點擊「下一步」。 -
在 Path 欄位中,手動輸入
:memory:。(這代表建立一個存在於記憶體中的實例,專門作為讀取外部檔案的跳板)。 -
點擊左下角 「測試連線」,若提示缺少驅動程式,點擊「下載」即可,完成後點擊「完成」。
Step 2: 透過 SQL 查詢資料
對著剛建立的 DuckDB 連線點擊右鍵打開 SQL 編輯器,輸入絕對路徑即可查詢:
-- 讀取單一 Parquet 檔案 (Windows 路徑請使用單斜線或雙反斜線)
SELECT * FROM 'C:\data\sampling_20230722.parquet' LIMIT 100;

-- 讀取資料夾下所有 Parquet 檔案 (適合分析切分過的時間序列資料)
SELECT * FROM 'C:\data\market_ticks\*.parquet';

-- 查看檔案的 Schema (欄位名稱與型態)
DESCRIBE SELECT * FROM 'C:\data\sampling_20230722.parquet';
方法二:使用 DBeaver 內建 Parquet 驅動
如果你使用的是較新的 DBeaver 版本,官方提供了直接視覺化連線的方式。
-
點擊 「新增資料庫連線」,搜尋並選擇
Parquet。 -
在連線設定的 Folder / File 欄位中點擊瀏覽,選定你要讀取的單一
.parquet檔案,或是包含多個 Parquet 檔的資料夾。 -
測試連線並下載必要驅動後點擊「完成」。
-
檔案會直接掛載於左側導覽列中。
進階技巧:零代碼的 UI 視覺化檢視 (Views)
無論你是使用 DuckDB 還是內建驅動,當連線建立後,DBeaver 為了節省記憶體,會自動在背景將這些外部檔案映射為「虛擬檢視表 (Views)」,讓你無須撰寫任何 SELECT 語法就能直接瀏覽資料。
操作路徑:
-
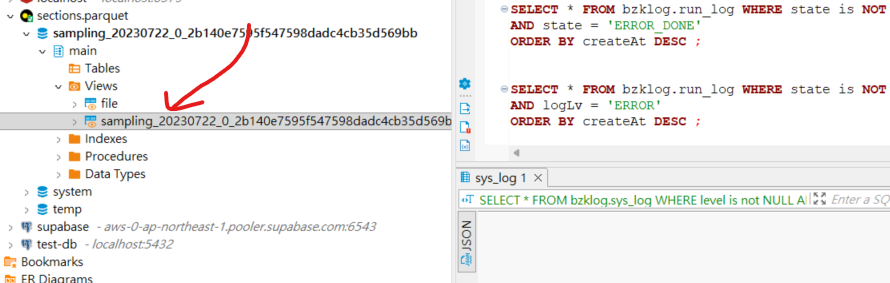
在左側的「資料庫導覽列」(Database Navigator) 中,展開你的連線實例(例如:
sections.parquet)。 -
依序向下展開目錄:
main(或 default schema) ->Views。 -
你會看到與檔名相對應的 View(例如:
sampling_20230722_...)。 -
連續點擊兩下 (Double-click) 該 View。
UI 操作優勢:
右側工作區會立即以試算表形式開啟資料分頁。你可以在資料列上方的面板直接進行:
-
點擊欄位標題:快速遞增/遞減排序。
-
Filter 篩選器:輸入條件快速過濾特定數值或字串。
-
Properties 檢視:切換到屬性分頁查看各欄位的精確資料型態。
實用補充:將 Parquet 轉換與匯出 (Export)
在確認資料無誤後,如果需要將 Parquet 轉交給其他不支援該格式的系統,DBeaver 提供了兩種快速轉出的方式:
方式 A:透過 UI 匯出 (適合小量資料或篩選後的結果)
-
在剛才開啟的 Views 檢視表上點擊右鍵,選擇 「匯出資料」 (Export Data)。
-
選擇 CSV 或其他所需格式。
-
依照精靈指示設定分隔符號、編碼 (建議 UTF-8) 與存檔路徑即可。
方式 B:透過 DuckDB SQL 高效轉檔 (適合海量資料)
如果檔案極大,直接透過 DuckDB 底層引擎轉寫成 CSV 速度最快:
SQL
-- 將 Parquet 檔案直接轉換並輸出成包含標題列的 CSV
COPY (
    SELECT * FROM 'C:\data\sampling_20230722.parquet'
) TO 'C:\data\output.csv' (HEADER, DELIMITER ',');